AIに開発とレビューを分担させると何が変わるのか — 契約・QA・別セッション・別モデルの実験記録
Claude Codeのクラウド実験から、開発とレビューの役割分担を比較した。親と3担当・単独・別セッション・別モデル・同一セッションのサブエージェントが、何を拾い何を見逃したかを整理する。
AI開発で肥大化したWindowsのDドライブを整理:Git worktree・Cargo target・検証資料を分けて退避した手順
AIエージェントとの開発で肥大化したWindowsのDドライブを、Git worktree・Cargo target・検証資料に分けて整理した実例。worktreeの正式な解除、別ドライブへの退避、SHA-256照合、移動後にAIエー ...
Claude Codeの無人実行を検証:56回のテストで見つかった終了判定とプロセス残留の問題
claude -p を無人で動かすとき、終了コード0だけで成功と判定すると何を見逃すのか。28ケース×2回(実Claude12回・擬似CLI44回)で検証し、Windowsのタイムアウト時の子孫プロセス残留と修正(taskkill/T ...
AIが作ったツールは、強制終了から正しく復旧できるのか? — SIGKILL・障害注入・途中再開を検証
テストが全て通るプログラムでも、実行中に電源が落ちたり、kill -9 で止められたりしたときに、前回の続きから正しく再開できるとは限らない。正常系のテストは、プロセスが最後まで生きていることを前提にしているからだ。
Cl ...
Claude Codeは実在OSSのバグを、正解を見ずに修正できるのか — Click・urllib3の診断3件を検証する
前回の記事「Claude Codeの「テストPASS」報告は何を保証するのか」では、AIが書いたコードを別のセッションがレビューすると、新しい問題が見つかることを紹介した。今回は逆向きの問いを扱う。AIは、実在するOSSの過去のバグを ...
Claude Codeの「テストPASS」報告は何を保証するのか — 別セッションのレビュー13件との比較
Claude Codeにプログラムの開発を任せ、百件以上のテストがすべてPASSしたと報告されたら、その品質をどこまで信用できるだろうか。
Claude Codeのクラウド環境で実施した一連の開発実験のうち、開発担当とは別 ...
Claude Haiku 5.5は実務でどこまで使えるか。9回の実装比較と候補判定で分かった使い分け
Haiku 5.5は3つの小規模実装タスクで全成功。一方、重要候補47件の判定では本番Codex構成より見逃しが増える方向でした。9 runと候補判定を分け、時間・概算費用・テストの検出力・再作業から限定導入を判断する手順を整理します ...
sourcemapのsourcesContentは、どのcommitのsourceか特定できるか。Git historyと照合するsourcemap-lineage
JSのsourcemapに含まれるsourcesContentをGit historyと照合し、同じsourceのcommitをgroupとして提示するCLI tool。Immer 10.1.1の実例で検証。
AI codingでGitだけでは分からなかった7つの問題を、小さなtoolにした
AI codingで、Gitのdiffやcommitだけでは分からない7つの問題を調べるために作った小さなtool、Timewitness/wipwho/Ember/Worldbisect/Afterimage/sourcemap-l ...
Git diffはclean。でもagent run中のfile操作は消えていないかもしれない。AfterimageでNTFS履歴を調べる
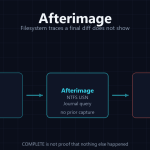
coding agentにタスクを頼んだあとgit diffがcleanでも、途中でファイルを作って消したり、内容を書き換えて元に戻した痕跡が、NTFSのUSN Journalに残っているかもしれない。事前起動不要で、agent se ...